 同一批芯片,CP(晶圆测试,Chip Probe)跑的是泰瑞达,FT(成品测试,Final Test)跑的是爱德万。两份测试日志摆在一起,一份翻开来几万行,另一份翻开来几百行。同一个参数,在一份里是一行,在另一份里是一列。想把两边拉到一张表上做关联——CP时电流偏高的那批,FT是不是更容易挂——脚本一跑,参数那一栏全是空的。数据没坏,是这两家对"参数"的定义根本不一样。
|
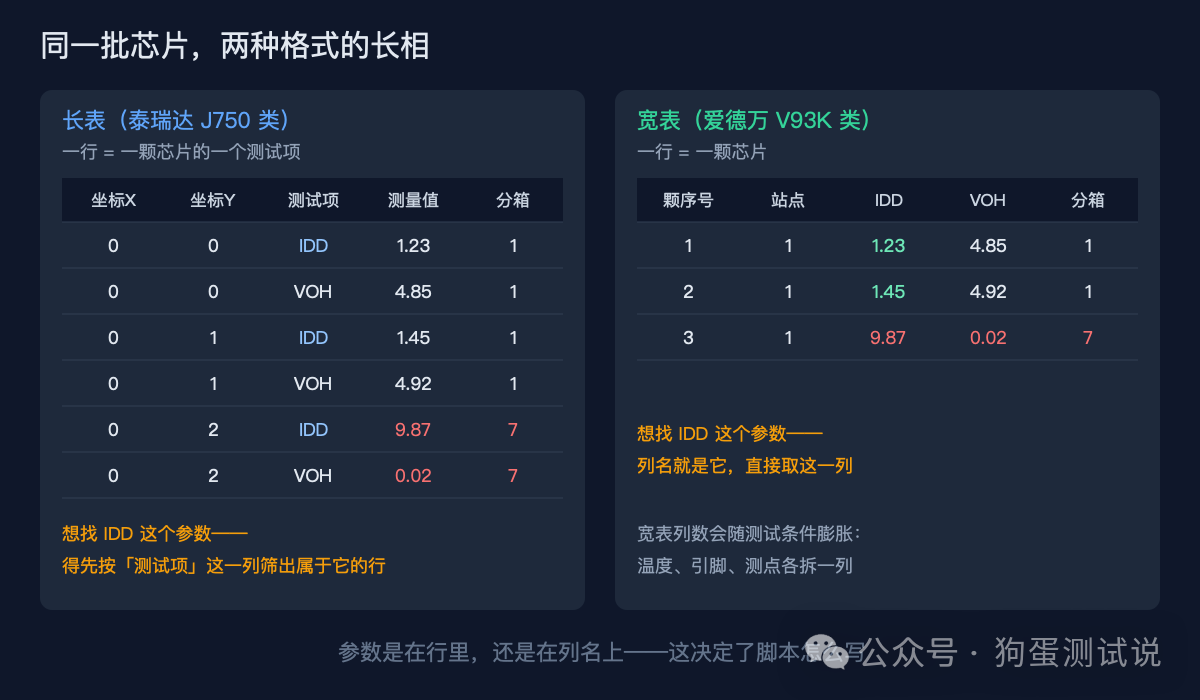
| 差异点 | 长表(泰瑞达J750类) | 宽表(爱德万V93K类) |
| 一行代表什么 | 一颗芯片的一个测试项 | 一颗芯片 |
| 参数在哪 | 「测试项」这一列的取值 | 列名本身 |
| 分隔符 | 逗号 | 空白,空格个数不固定(以我经手的导出文件为准) |
| 文件开头 | 井号打头的注释行 + 列名行 | 列名行,前面也可能带元信息 |
| 测试条件(温度、引脚、测点) | 常塞进测试项名里 | 常拆成不同的列 |
| 同一颗芯片出现多次(重测) | 多一行 | 多一行,或被覆盖 |
一套脚本对一个格式,迟早出问题
写两套解析脚本,看着挺直接:长表一套、宽表一套。问题在口径会漂。
统计"某个参数有多少颗芯片测过",长表按唯一记录键数,宽表数的是某一列里的非空值。长表里同一颗芯片首测、重测各占一行,直接数行就把这颗数了两遍。两套脚本各写一遍,半年后有人只改了一边,另一边的报告就差了一截——两个报告长得一模一样,数字却对不上,谁也没看出来。
前面聊过一个项目,CP1和CP2的数据,两位工程师没对齐列顺序,两份良率报告差了14个百分点。那是列错位,数据搬错了位置;今天这个更隐蔽,数据一个字都没错,是同一个参数被两套脚本各算了一遍,算成了两个数。
再往后成本更高:每上一台新机台、一个新器件型号,脚本数量跟着涨一轮。
归一化:先定表,再读文件
统一解析层的思路就一句:每个厂商格式写一个"翻译器",出口都是同一张表。下游所有分析脚本只认这一张表的列名,不认识J750,也不认识V93K。
第一步,先把统一表的列定下来,一共十六列,分三组:
· 认芯片:批次、晶圆号、Die_X、Die_Y
· 记这一次:站点、测试阶段(CP还是FT)、测试条件(温度)、重测序号、程序版本、来源文件
· 认结果:测试项名、测量值、单位、规格下限、规格上限、分箱结果
来源文件记成「文件名#行号」,出了事能追回哪台机台哪个文件的第几行。测试项里不全是数字——有些项吐出来的是字符串或者Pass/Fail标记,硬转数值会变成NaN,整列悄悄丢掉,这类项单独留一列文本结果。
第二步,一个格式配一个翻译器。长表照搬"测试项名+测量值"两列;宽表把列名竖过来变成行;T2000先扫到测量数据那一段的行号,再从那里开始读。测试条件在长表里常藏在测试项名的后缀(IDD_150C),在宽表里是单独一列——翻译器把它拆出来落到同一列,同一个参数才不会被拆成两列。翻译器里只做格式转换,不做任何业务判断。
第三步,身份键对齐。得分两层。
芯片身份只回答"这是哪一颗":批次、晶圆号、Die_X、Die_Y。一次测量再加上测试阶段、测试条件(温度)、重测序号,才是"这一次测试"的身份。
同一颗芯片高温测一遍、常温测一遍,是两条记录,不是重复行。测试条件跟着记下来,不然高温那遍会被当成重复行合掉。宽表常见的是一串颗序号(PartID),坐标不一定在这份文件里——先用批次+晶圆号+颗序号把记录立住,再拿晶圆Map或STDF里的坐标映射回来;映射不上的宁可留空报出来,也不要按序号顺序去猜。这一步偷懒,后面合出来的东西就不是芯片了。
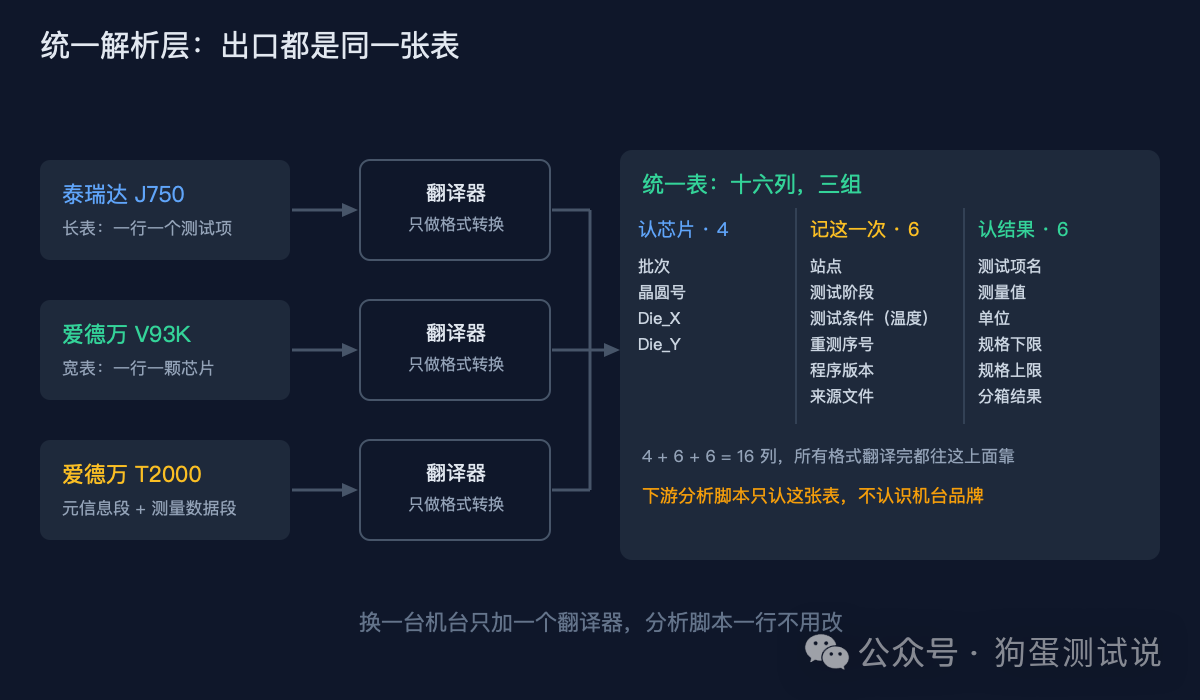
图二 每个厂商格式一个翻译器,出口都是同一张统一表,分析脚本只写一遍
最险的一步:长表转宽表
归一化里最容易出事的地方,是把长表转成宽表——把"测试项"这一列里的值竖起来当列名。做这件事用的是透视。
同一颗芯片、同一个测试项,如果表里有两行,透视就逼你回答一个问题:留哪一行?
两行从哪来?最常见的是失效自动重测——首测挂了,产线自动复测一遍,两次结果都留在日志里。
举个例子。某个参数的规格是1.20~1.80。一颗芯片首测1.92,超限判了失效;自动复测1.44,判合格——探针多扎了一遍,接触状态跟第一遍不是一回事。透视用了默认聚合:(1.92+1.44)÷2=1.68,落进了规格线以内。
这颗芯片在分析表里既不是首测值,也不是复测值,是一个物理上不存在的数。它长得毫无破绽:量程内、分布连续,散点图上一团正常。芯片的合格与否是机台测试时实时判定的,脚本改不了;脚本改的是你报告里看到的那个数——报告里,这一项没有超限的芯片。
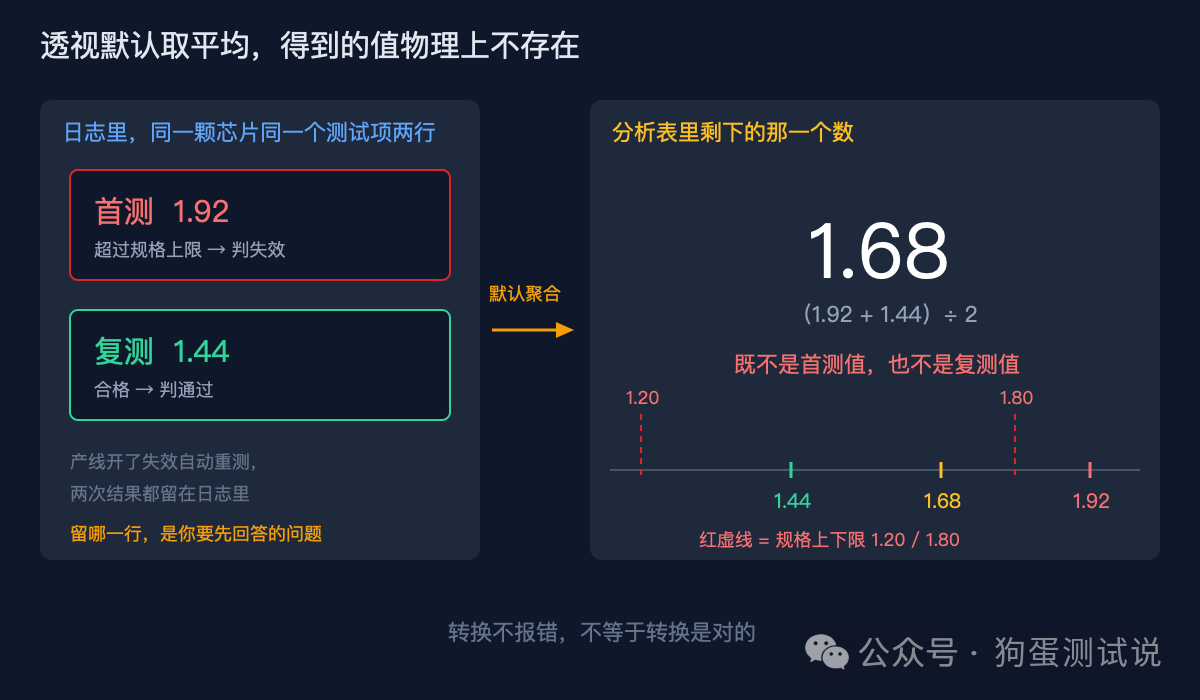
图三 首测1.92超限、复测1.44合格,透视默认取平均得到1.68,落进规格线以内
怎么修?也是三步。
转换之前先把口径定下来。看首测能力,用第一次的结果;看出货判定,用最后一次。这个决定得由人写下来,别交给函数的默认值——它不知道你要回答哪个问题。两个口径的差别别扔:首测挂了、复测才过的那些记录,重测序号留着,探针什么时候该洗、该换,看的就是这个比例。
重复行自己聚合成一行。按记录键分组,显式写明取第一次还是取最后一次,聚完再透视。这样每一步做了什么,脚本里看得见。
最后加断言。透视后的行数,应该等于唯一记录键的个数——颗数乘上测试条件的个数,对不上就说明有行被合并掉了;测试项的列数,要跟翻译器扫到的测试项数对上;再随手挑几颗芯片,把宽表里的值跟原始长表里的行逐条比一遍。
�� 狗蛋说:统一解析层省下的不是写脚本的时间,是"两份数据能不能放在一起比"的资格。格式不一样,你也能硬算出两个良率,但那是两个口径,摆在一张图上是自欺欺人。我给自己定的规矩是:任何一次转换都要有行数、颗数和测试项数的断言。转换不报错,不等于转换是对的——pandas(Python数据分析库)最擅长的事,就是安安静静地把你的数据改成另一个样子。
评论区
你们厂CP和FT是同一家的机台,还是两家混着用?有没有过那种"两份日志明明是一批芯片、数出来的良率却对不上"的经历?评论区聊聊,我也想听听。
�� 芯片测试狗蛋说 · 16年测试老兵