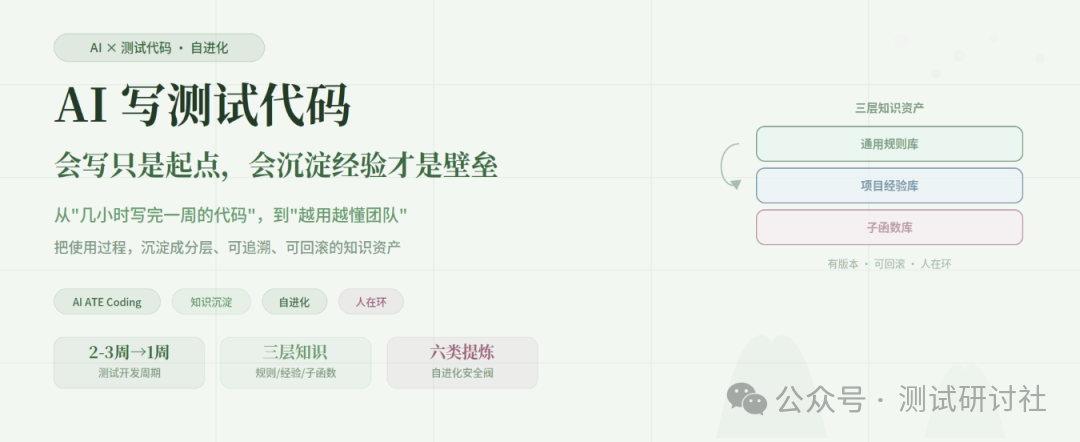
  在 AI 赋能测试的诸多方向里,最有体感的一块,是从规格到测试程序的自动生成——它能把一颗芯片的测试开发,从传统的两三周压到一周左右。但当你真的把它带进产线、长期使用,会撞到一个更深的问题:系统不能每次都像"第一次写代码"。会写,只是起点;会在使用中不断沉淀团队经验、自我进化,才是真正的壁垒。这篇把"自动生成"的全景和它的深水区,一起讲清楚 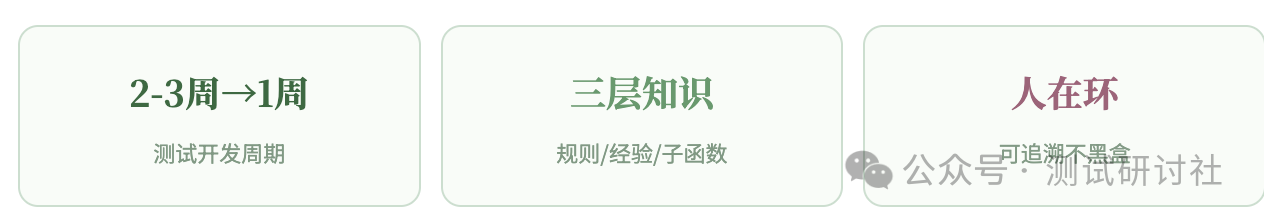 Datasheet 提取参数、参考历史模板生成标准化测试项、把多电压/多温度条件自动展开、生成结构化的测试机代码草稿(含 Pin Map、Level、Timing、Flow),再自动做语法检查与编译验证。落到效率上,我自己带的一个 AMR 传感器项目,测试开发就从传统的两三周压到约一周,总周期压缩约 70%。 但要清醒地看到:这一切解决的,是"如何生成一次可运行的代码"。它很有用,却还不是终点。 二、为什么"会写"还不够:系统不能每次像第一次如果 AI 每次写代码,都只依赖固定的提示、静态的规则文件和少量参考案例,那么它单次效率很高,却很难持续吸收工程师的经验:今天你纠正的一个测试机语法细节,明天可能还得再提醒一次;某个项目里反复验证有效的代码组织方式,换到下一个类似项目又要重新解释;一个常用的 helper function,它可能每次都重新造一遍。 这已经不是"代码生成能力"的问题,而是"工程经验沉淀能力"的问题。ATE 代码的特殊性正在于此——它不是普通 C++,背后是测试机资源、板卡连接、relay 切换、pin mapping、测试模式、量测时序、limit 判断、debug 习惯和一堆产线约束。同一个测试项,不同工程师有不同实现风格;同一个资源冲突,不同项目有不同绕法;同一个报错,资深 TE 一眼能看出是资源名错、调用顺序错,还是测试条件没初始化。 ⚠️ 关键难点:这些经验大多不会完整写进手册,它们散落在项目代码、debug 记录、口头反馈、临时修改和 review 意见里。系统若不能持续吸收它们,就只能停在"照着资料生成代码",永远贴不近团队真实的工程习惯。这也正呼应了一个老痛点——测试经验高度依赖资深工程师,人一走,经验就散了。 三、把经验分层:三类知识不能混在一起要让系统"越用越懂",第一步是把要学的东西分清楚。一个能落地的自动生成系统,应该具备三种学习能力,对应三个互相独立的知识库: 通用规则库:团队的通用编码规则——比如某类资源的初始化顺序、某种语法禁用写法、某个 API 的固定调用约束。 项目经验库:项目级的实现经验——某类测试项在某产品上的组织方式、某个 pin/resource 的使用模式。 子函数库:工程师常用的封装方式——哪些逻辑该抽成 helper、参数怎么传、封装和资源初始化顺序怎么绑定。 为什么必须分开?因为一旦混在一起,系统很容易把某个项目的特殊写法误当成全局规则,或者把一次临时的 debug 记录固化成长期知识——这会污染以后所有项目。 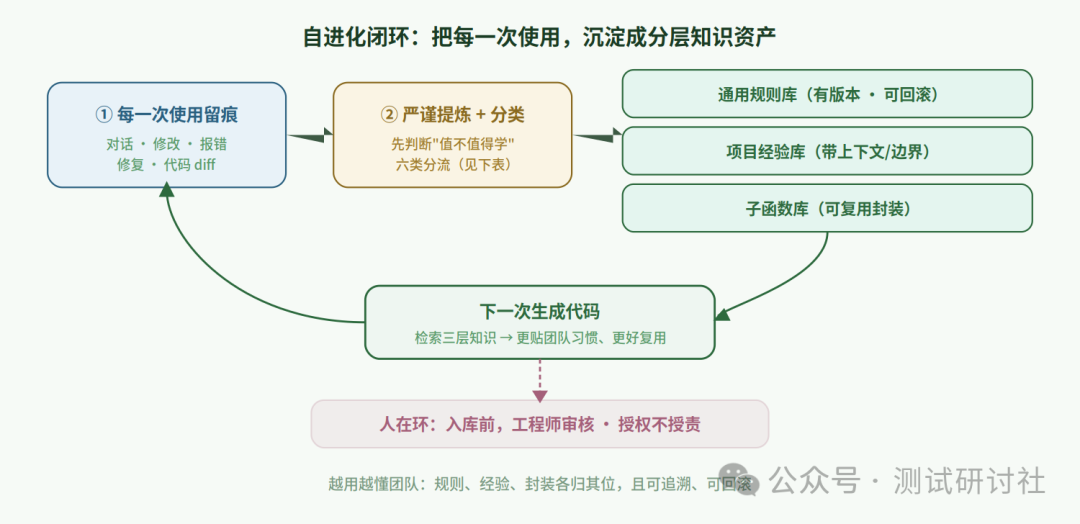 使用留痕 → 严谨提炼分类 → 分层入三个知识库 → 反哺下一次生成;入库前由工程师审核,全程可追溯 四、规则库要有生命周期,而不是越堆越乱通用规则库最容易走的弯路,是"把所有反馈都往里塞"。正确的做法是先判断:这条经验值不值得成为规则。 能泛化到大多数项目的,才升级为全局规则;只适用于特定项目、板卡、测试类型的,标成专用规则并写清边界,而不是硬升成全局。 已有规则覆盖的,不重复添加,避免规则库膨胀;旧规则若表述不准、适用面过宽、与新经验冲突,要能被修改、降级甚至废弃。 每一次规则变更都保留版本快照,支持回滚与审计。 只有这样,规则库才不会变成一个谁也说不清的"提示词垃圾场",而是一个有生命周期、有审计记录、有适用边界的工程资产。 五、项目经验 ≠ 全局规则不是所有有价值的经验都适合当规则。ATE 里很多经验是项目特定的:比如某个模拟芯片项目里,工程师最终确认某类 leakage 测试更适合先统一配置 relay、再分组做 force/measure;某个量产项目里,某种 pin group 的资源分配能减少切换时间;某次 debug 里,把一段复杂测试项拆成几个更易校验的函数块。 这些对相似项目很有参考价值,可一旦写进全局规则,就可能误导别的项目。正确的沉淀方式,是保留它的上下文、适用范围和参考价值,放进项目经验库,供后续相似项目在生成时检索参考——而不是强行规则化。企业里的工程经验,往往不是"真理",而是"在某类项目里验证有效的做法",这一点尤其要拎清。 六、别让系统"学错":提炼必须先分类自进化系统最怕的,不是学得慢,而是学错。如果把所有反馈都写进长期知识库,它很快会被临时 debug、偶然的项目约束、甚至错误修改污染。所以提炼结果必须先分类、再决定去留。一个实用的分法是六类:
��️ 这套分类是自进化的"安全阀":它允许系统学习,但不允许它无边界地记忆。尤其"临时 debug 记录"和"价值不足"这两类,必须明确挡在长期知识库之外——否则一次临时修复,就可能影响后续所有项目。 七、人始终在环:三个阶段,越往后越自动把这件事放到时间轴上看,AI 写 ATE 代码大致有三个成熟阶段——而无论走到哪一步,人都不该离开这个环。 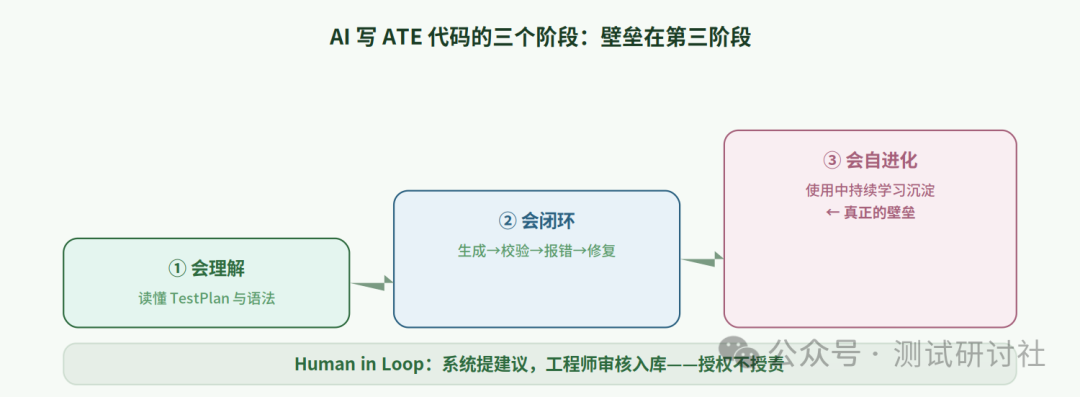 第一阶段比"会理解",第二阶段比"会闭环",第三阶段比"会在使用中持续学习"——壁垒在第三阶段 真正可靠的自进化,一定是人在环的:系统只负责"提建议"——提出规则更新、经验沉淀、子函数入库的候选;由工程师审核后,才进入正式知识库;每次更新都带版本、来源、适用范围和回滚机制。这样,AI 的学习就不是黑盒,而是可追溯的工程知识沉淀。它也不能脱离工程师去自主修改产线规则——这既是安全底线,也是"授权不授责"的本意。 八、这对 TE 团队的长期价值短期:减少重复提醒。指出过的问题下次尽量不再犯,修过的代码模式能复用,常用 helper 不用每次重造。 中期:提升一致性。不同工程师、不同项目、不同产品线的代码风格,逐步收敛到团队认可的规范;经验库和子函数库让新项目启动更快。 长期:把隐性经验变成组织资产。资深 TE 脑子里"某类测试怎么组织更稳、某类资源怎么分配更少出错、某个报错通常意味着什么",一旦进入可版本化的知识库,就能被新人、新项目、新产品线复用。 这恰好接上了 AI 赋能测试的那条主线——让知识不流失。自动生成的价值,从来不只是"几小时写完原本一周的代码",更大的价值,是让测试开发从一次性的产出,变成一个会积累、会复盘、会进化的系统。 结语:会写代码只是起点AI 写 ATE 代码,第一阶段比的是能不能读懂 TestPlan 和测试机语法;第二阶段比的是能不能形成生成、校验、报错、修复的闭环;第三阶段,比的就是能不能在工程师的持续使用中不断学习。 成熟的系统,不应该每次都从固定提示出发,也不该把所有经验粗暴塞进一个大文件。它需要分层的知识结构、每一次使用的记录、严谨的提炼分类、有生命周期的规则、带边界的项目经验、可复用的子函数,以及版本快照与回滚。本质,是把"静态规则 + 一次性生成",升级为"使用记录 + 严谨提炼 + 分层沉淀 + 版本可回退"的自进化闭环。当工程师持续用它,它就不再只是一个会写代码的 AI,而会慢慢长成一个懂团队习惯、懂项目经验、懂测试机代码风格的测试开发系统。 |